26/09/2026
Higgins : un orchestrateur d'agents qui préfère la fiabilité à l'autonomie
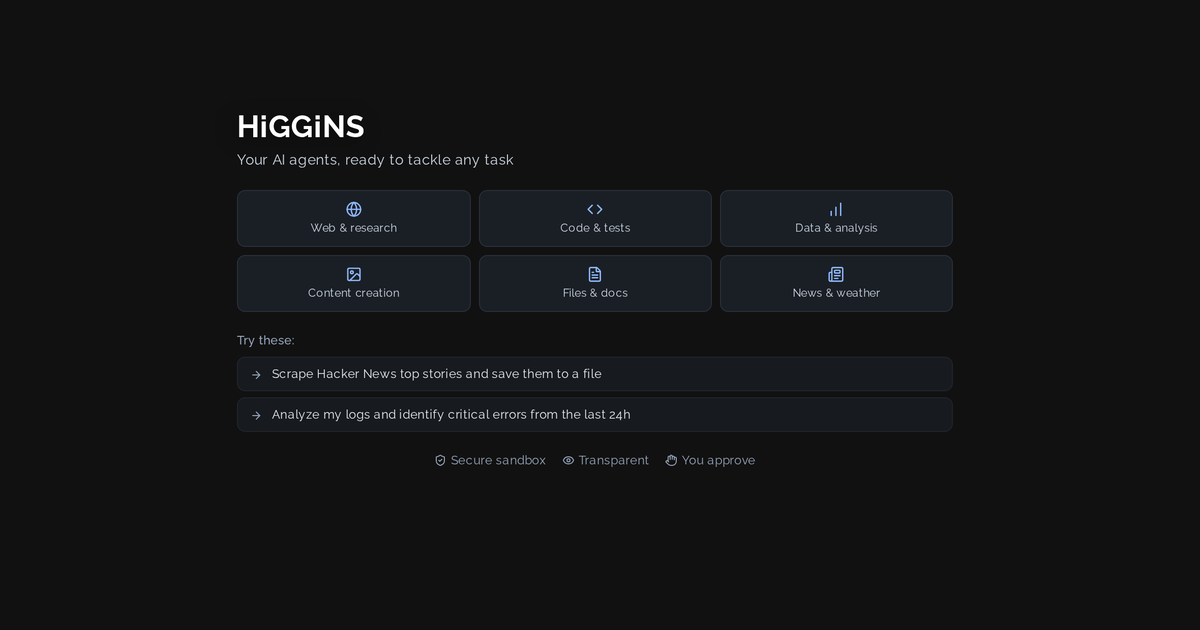
En novembre 2025, j'ai commencé à écrire Higgins. Je voulais déléguer des tâches à des agents IA (chercher, lire des documents, écrire du code, analyser des données) sans renoncer à comprendre ce qu'ils faisaient. Les outils que j'essayais promettaient beaucoup d'autonomie et offraient peu de visibilité : quand un agent se trompait, je ne savais ni où, ni pourquoi, ni combien cela avait coûté.
Onze mois et 257 commits plus tard, Higgins tourne en production sur mon serveur. Cet article présente ce qu'il fait, les principes qui guident sa conception, et ce que son exploitation m'a appris.
Ce que fait Higgins
Higgins reçoit une demande en langage naturel et la confie à l'agent le plus adapté. Un agent routeur choisit le spécialiste (recherche web, code, fichiers, données, images…) et affiche la raison de son choix. Le spécialiste travaille ensuite avec les outils qui lui ont été accordés, et seulement ceux-là.
Concrètement :
- Plus de 60 outils : lecture et écriture de fichiers, recherche, requêtes HTTP, exécution de code, e-mail, traitement d'images…
- Un bac à sable Docker pour tout code exécuté, avec des limites de CPU, de mémoire et de disque, et un réseau fermé par défaut.
- Des projets : chaque session travaille dans un espace de fichiers isolé.
- Des skills : des procédures documentées que l'agent charge seulement quand il en a besoin.
- Le protocole MCP pour brancher des outils externes, soumis aux mêmes contrôles que les outils internes.
- Des routines : des demandes envoyées à un agent selon un planning.
- Plusieurs modèles via OpenRouter, avec un modèle de secours si le premier ne répond pas.
L'architecture reste volontairement simple :
Navigateur → Flask → file Beanstalkd → worker d'agents
                                          ↓
                          routeur → agent spécialisé → outils
                                          ↓
Navigateur ← flux SSE (Redis) ← progression, appels d'outils, résultats
Une exécution d'agent peut durer des minutes, parfois des heures. Elle n'a donc rien à faire dans une requête HTTP : le serveur web dépose la tâche dans une file, un worker séparé l'exécute, et le navigateur suit l'avancement en direct. Si le worker tombe, l'interface reste debout.
Premier principe : tout montrer
Dans Higgins, rien ne se passe hors de la vue de l'utilisateur :
- chaque appel d'outil apparaît avec ses arguments et son résultat ;
- le raisonnement du modèle est affiché quand le modèle le fournit ;
- le coût est suivi par session, par utilisateur et par mois, avec des plafonds ;
- une jauge indique le remplissage de la fenêtre de contexte et le taux de cache ;
- si le modèle de secours a pris le relais, l'interface le signale : on sait quel modèle a réellement répondu.
Tout est aussi conservé en base : exécutions, appels d'outils, niveaux de confiance, coûts. Quand un résultat surprend, on peut reconstituer ce qui s'est passé.
Deuxième principe : l'humain règle l'autonomie
Chaque outil est analysé à son enregistrement pour détecter ce qu'il sait faire : lire ou supprimer des fichiers, sortir sur le réseau, lancer un processus… Pour chaque couple agent-outil, l'administrateur choisit ensuite un niveau d'autonomie : supervisé (chaque action est validée), guidé, de confiance ou autonome. La première fois qu'un agent utilise un outil, une carte présente ses capacités et demande une décision.
Certaines actions restent soumises à validation à tous les niveaux, comme la suppression de fichiers. Et un appel qui transporterait un secret, un IBAN ou un numéro de carte vers l'extérieur attend une approbation humaine.
Enfin, un suivi de confiance accompagne chaque exécution. Chaque étape réussie ne l'érode presque pas ; les erreurs et les répétitions, beaucoup plus. Sous 50 % de confiance cumulée, l'agent s'arrête et demande une revue humaine. En effet, même avec une bonne fiabilité à chaque étape, les erreurs se cumulent sur une longue chaîne d'actions.
Troisième principe : mesurer plutôt que promettre
Modifier la description d'un outil ou changer de modèle peut améliorer un cas et en dégrader trois autres. J'ai donc construit un banc d'évaluation hors ligne : des tâches décrites en YAML, exécutées par le vrai moteur d'agents dans un bac à sable jetable, et notées sur le succès, le nombre d'appels d'outils, les erreurs, les tokens et le coût. Deux versions se comparent côte à côte, métrique par métrique.
En production, un tableau de bord suit la fiabilité de chaque outil et le taux d'échec par agent et par modèle. C'est ce qui permet de décider sur des chiffres, pas sur une impression.
Ce que la production m'a appris
Les problèmes les plus coûteux ne venaient pas des modèles, mais de tout ce qu'il y a autour.
Un réglage par défaut qui coûtait 30 % du budget. La file Beanstalkd remet en circulation toute tâche réservée depuis plus longtemps qu'un délai donné. Ce délai n'était pas précisé : la valeur par défaut, 60 secondes, s'appliquait. Chaque exécution de plus d'une minute était donc relancée, une fois par minute, par un autre worker. Les journaux de production l'ont montré : 21 % des requêtes exécutées plusieurs fois, 30 % de la dépense en modèles gaspillée. Une même session avait démarré six fois, à exactement 60 secondes d'intervalle. Pire, les copies rejouaient des outils sur un espace de travail déjà modifié. Le correctif tient en deux points : un délai explicite qui dépasse l'exécution la plus longue, et une réservation atomique de chaque demande qui interdit de l'exécuter deux fois.
Forcer le modèle à appeler un outil le fait tourner en rond. L'option tool_choice: "required" semble rassurante : le modèle doit agir. Mais elle lui interdit de terminer son tour par une simple réponse. Sans outil explicite de fin, un modèle moins performant boucle alors jusqu'à la limite d'itérations. Higgins laisse désormais le modèle conclure en texte, et bloque les appels identiques répétés en lui expliquant pourquoi.
Le bouton Stop doit toujours gagner. Trois composants lisaient le même signal d'interruption, et le premier à le lire l'effaçait. Selon le moment, l'agent reprenait après que l'utilisateur avait cliqué sur Stop. Désormais, un seul composant consomme ce signal, les autres se contentent de le consulter.
Aucun de ces problèmes ne se voit dans une démonstration. Tous sont apparus en production, et tous ont été trouvés parce que le système enregistrait assez de traces pour remonter à la cause.
Ce que Higgins ne fait pas
Higgins n'est pas un agent autonome à qui l'on confie un objectif flou. Il donne ses meilleurs résultats sur des tâches bien délimitées, avec des outils choisis. Une exécution interrompue ne peut pas encore reprendre là où elle s'était arrêtée. Et sa documentation de sécurité liste aussi les écarts connus entre l'intention et le comportement réel : je préfère les écrire que les découvrir chez un utilisateur.
Et pour vos projets
Les garde-fous de Higgins sont ceux que j'applique aux systèmes que je construis pour la finance et le juridique : des actions tracées, une validation humaine là où l'erreur coûte cher, et une fiabilité mesurée sur des données réelles avant la mise en production.
Si vous avez un agent ou un système LLM à rendre fiable, parlons-en.